Fredagens briefing

Dagens Vibes — 18. september 2026

Modellen er ikke længere hele produktet. Dagens stærkeste ting handler om koordinering, tætte feedback-loops, specialister i kæden — og 27 milliarder parametre presset ned i håndbagage.

Fra X-feedet

Claude bliver den vedvarende projektleder

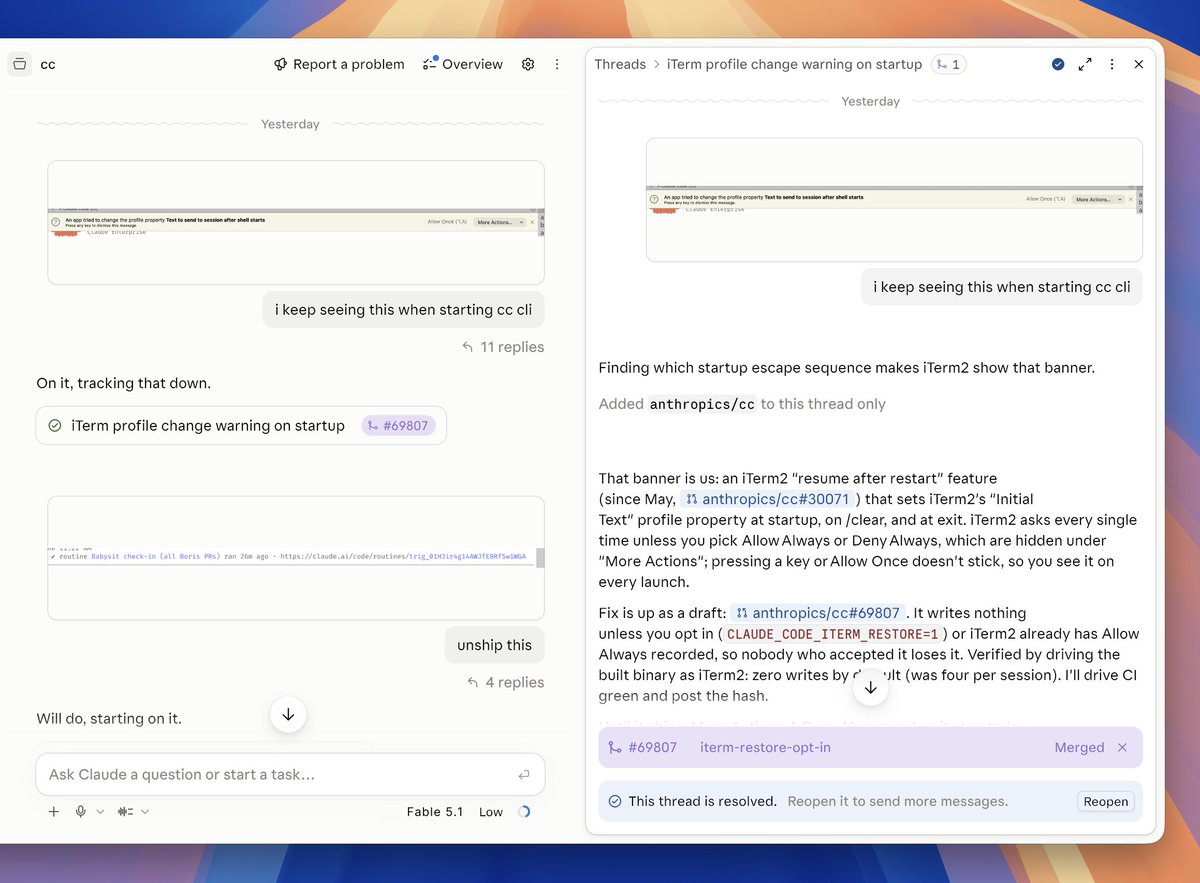
Projects samler et mål i én løbende samtale, fordeler arbejdet på parallelle cloud-tråde og husker beslutninger på tværs. Boris Cherny beskriver det egentlige skift: han er holdt op med at administrere sessions og sender bare tanker ind, efterhånden som de opstår.

Boris Cherny@bcherny
Projects have changed not only how I interact with Claude but how I code. I stopped managing sessions. I just send thoughts as they come, Claude splits them into threads, and the project remembers how I work. It's where I do a ton of my coding now. [screenshot: my actual prompts for claude code cli yesterday]
Boris Chernys Claude Projects-forløb
♥ 2.076   ↻ 76   💬 203   🔖 1.700
https://x.com/bcherny/status/2100669598995816511

Ethan Mollicks vibe check er dejligt urimelig: Projects fik billeder, video og kataloger og byggede et 3D-kort over Umberto Ecos 33.000 bøger. Siden markerer selv, hvad der er sikkert, gættet og ukendt — agentarbejde med synlige sømme.

Ethan Mollick@emollick
I had access to the new Claude Projects and was able to do some very complex work. Here, I asked it to go through all the images, videos and records about Umberto Eco's famous 33,000 book library & try to reconstruct it, including book locations, in 3D. https://eco-library-map.netlify.app/
3D-kort over Umberto Ecos bibliotek
♥ 463   ↻ 32   💬 31   🔖 197
https://x.com/emollick/status/2100651315617800358

Læs Projects-dokumentationen · Gå gennem Ecos bibliotek

GLM bygger maskinrummet, der kører GLM

GLM-5.3-Flash gik fra første kørsel til produktion på under to uger og tredoblede throughput. Den vigtige opskrift er ikke “mere autonomi”, men tæt feedback: agenten kunne koble fejl og flaskehalse til konkrete kernels, traces, mikrobenchmarks og kontrollerede forsøg.

Z.ai@Zai_org
We’re sharing how GLM-5.3 helped build and optimize the inference infrastructure serving GLM-5.3-Flash. The system went from its first successful run to production readiness in less than two weeks, with end-to-end throughput tripling relative to the initial baseline. The key was dense feedback: local correctness tests, execution traces, microbenchmarks, and end-to-end measurements that enabled targeted hypothesis testing rather than reliance on aggregate performance metrics alone. https://z.ai/blog/glm-built-its-inference-infrastructure
♥ 3.815   ↻ 444   💬 155   🔖 1.671
https://x.com/Zai_org/status/2100481236364079277

Læs den tekniske gennemgang og de tre fejl, agenten fandt

Jev finder sit job mellem de store modeller

Efter gårsdagens lancering kommer de nyttige tests: en security-pipeline blev over fem gange billigere og samtidig mere præcis, mens 1.018 forskningsartikler blev klassificeret for otte cent. Den stærke arkitektur er model-mix: en god sprogmodel komprimerer, Jev træffer tusind små typed beslutninger.

Greg Pstrucha@grichadev
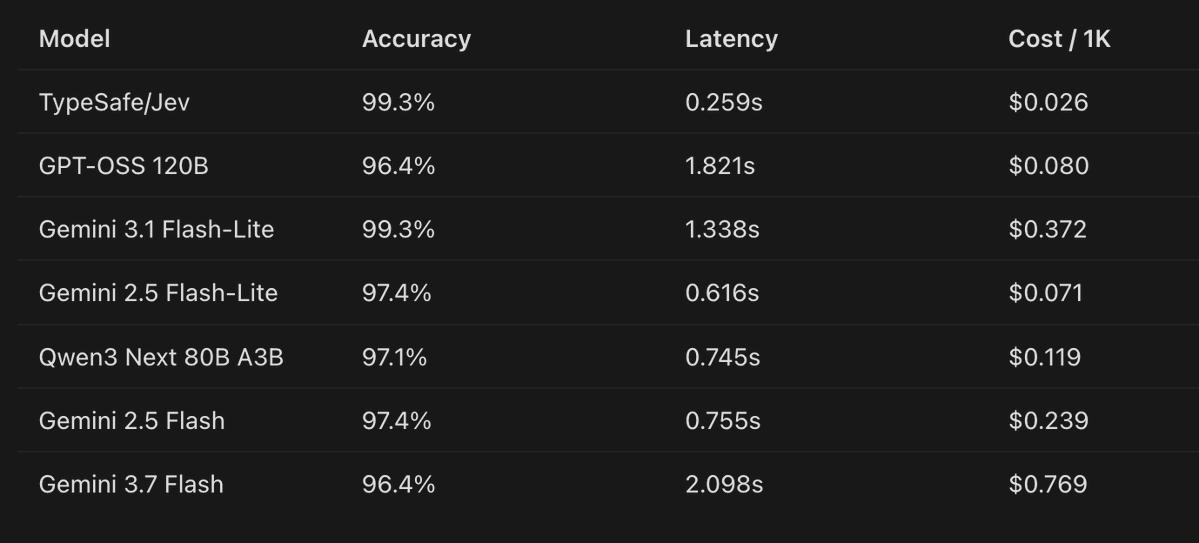
these are results of using jev on one of our security pipelines. we already have to use smaller (and dumber) models to make it economic and this model does it over 5x cheaper, faster and while maintaining much higher accuracy. i don't normally hype over new model releases but that's the first one that actually impressed me. good job @typesafeai
Resultater fra Jev i en security-pipeline
♥ 905   ↻ 39   💬 20   🔖 226
https://x.com/grichadev/status/2100437998571860087
Hassan@nutlope
I used Jev to classify 1,018 AI research papers. The result: $0.08 total cost and 256ms median end-to-end latency per paper. The pipeline was: 1. Summarize each paper with DeepSeek V4 Flash 2. Send the title + summary + 24 possible topics to Jev 3. Use Jev to classify each paper 4. Visualize everything on the site The summaries cost $3.99. The classifications cost $0.08. I think this is where things are heading: different models for different parts of the workflow, instead of using one model for everything.
Visualisering af klassificerede AI-artikler
♥ 1.829   ↻ 121   💬 104   🔖 1.761
https://x.com/nutlope/status/2100426999546184123

Jevs tekniske lancering

Agent-interfacet er også en modelparameter

Seks komplette runs på 226 præcise redigeringsopgaver: notebook-mode slog struktureret JSON med 1,99 procentpoint og efterlod én terminalfejl mod syv. Lille benchmark, stille tweet, stor pointe — harnesset kan flytte mere end endnu et prompt-adjektiv.

Howaboua@Howaboua
Someone opened an issue in my repo to submit their benchmark result and suggest I add their badge. Bold xD So I ran the damn thing against structured JSON mode and notebook mode myself. Six full Explicit Edit Benchmark runs. 226 tasks each, three runs per mode, Luna at low reasoning. Same Pi Codex config. - Structured JSON: 94.54% - Notebook: 96.53% - Notebook won by 1.99 points and left 1 terminal failure instead of 7 - Recorded model cost for all six runs: $2.89 No tool-call failures. No event errors. Notebook Mode wins.
♥ 2   ↻ 0   💬 0   🔖 0
https://x.com/Howaboua/status/2100670847619060042

Se benchmarkens data og metode

En 27B-model flytter ind på laptoppen

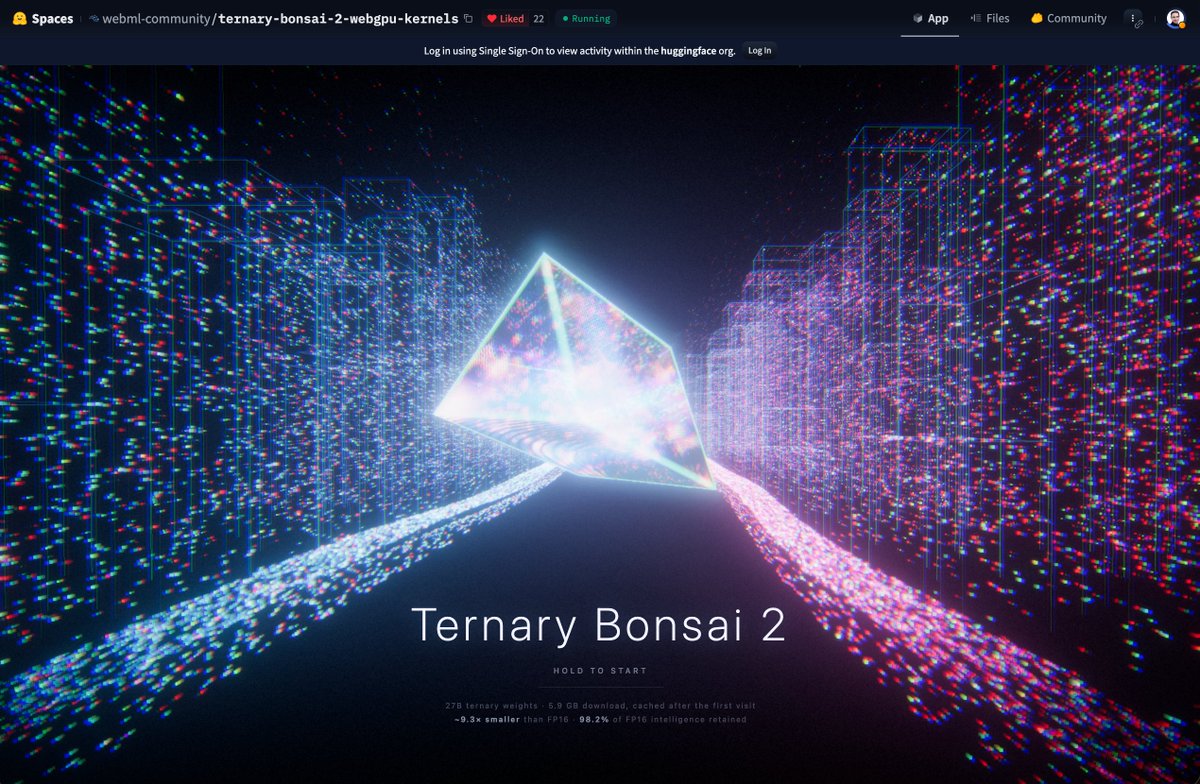
Bonsai 2 presser Qwen3.8 27B ned i 5,9 GB ternary weights og hævder 98,2 procent af full-precision-scoren. Onurs første datapunkt er cirka 30 tok/s i browseren på en MacBook Pro; kvaliteten mangler stadig den uafhængige tur gennem vridemaskinen.

Onur Solmaz@onusoz
Exciting! PrismML just launched a version of Qwen3.8 27B weights that are compressed down to 5.95 GB and that runs on my browser on Macbook Pro with 30 tok/s If it indeed is as lossless as they claim, then this will be a gamechanger for devices with 16 GB of ram! I will run some benchmarks on it and will keep you posted! Go try it out in the Hugging Face space: https://huggingface.co/spaces/webml-community/ternary-bonsai-2-webgpu-kernels
Bonsai 2 27B kører lokalt i browseren
♥ 30   ↻ 3   💬 5   🔖 10
https://x.com/onusoz/status/2100774214022410280

Læs release, benchmarks og runtime-forbehold

Nyhedsbonus

Anthropic satte Claude til at optimere mere end 30 open-source biomodeller på fire uger. De blev cirka fire gange hurtigere i gennemsnit, og en ny low-memory-tilstand kan folde systemer over 10.000 tokens på én GPU-node; al den optimerede kode er udgivet.

Anthropic · 17. september

Claude gør biomolekylære modeller hurtigere og mindre sultne

FlashPairformer-kernels, 30+ optimerede modeller og sammenlignelig protein-designkvalitet med omtrent 100 gange færre GPU-timer.

Google gør CC til en delt familieagent med sin egen konto, fælles hukommelse og selektiv adgang til mail, kalender, filer og opgaver. Den kan udfylde tilladelsessedler og samle skolelogistik — praktisk, men foreløbig et amerikansk Labs-forsøg.

Google Labs · 17. september

CC bliver familiens fælles logistikagent

Op til seks personer kan dele kontekst med agenten, mens hver bruger selv vælger, hvilke mails, filer og kalendere den må se.