Torsdagens briefing

Dagens Vibes — 24. september 2026

AI-agenten rykker ud af chatboksen og ind i laboratoriet, browseren, brillerne og performance-teamet. Det interessante er mindre, hvad modellerne lover, og mere hvad folk faktisk får dem til at gøre.

Fra X-feedet

Claude i laboratoriet: et muligt nyt DNA-system

950 agenter gennemgik genetiske data i 21 timer og pegede på et hidtil ubeskrevet enzymsystem. Mennesker testede fundet i laboratoriet; funktionen er endnu ukendt, så CRISPR-sammenligningen er en retning, ikke en opdaget genredigeringskur.

Anthropic@AnthropicAI
Claude has discovered a previously unknown enzyme system hidden in the DNA of bacteriophages. Beside the enzyme’s gene sits a long array of repeating DNA—a structure that looks somewhat similar to CRISPR. We don’t yet understand what this system does, but only a handful of known systems share its features, and all of them are able to cut, copy, and paste DNA. Historically, the discovery of such programmable systems has helped revolutionize medicine. CRISPR, for instance, is now the foundation of genetic medicines. But it will take much more work to learn what this system does, and whether it can be put to similar use. Read more: https://t.co/RuEosScSMb
♥ 32.662 · ↻ 3.979 · 💬 1.100 · 🔖 9.620
x.com/AnthropicAI/status/2102824959827742916
Anthropic · Forskningsberetning

Claude finder array-associated reverse transcriptases

Metode, menneskelige laboratorieforsøg og link til preprint.

150 tråde, 3.000 ændringer og én målelig hastighedsgevinst

Anthropics lange tekniske beretning er dagens stærkeste agent-case: Claude fandt performanceflaskehalse, byggede målinger og optimerede claude.ai omkring tre gange på to uger. Folk satte mål, godkendte ændringer og smed dårlige benchmarks væk.

ClaudeDevs@ClaudeDevs
We made claude​.ai 3x faster in two weeks. Here’s how we use Claude to measure, debug and improve performance. Prompts and methods included. https://t.co/mgvK8mJRuD
♥ 6.254 · ↻ 338 · 💬 161 · 🔖 5.548
x.com/ClaudeDevs/status/2102839691154427983
Claude · Teknisk dybdedyk

Sådan gjorde de claude.ai hurtigere

Fra statisk composer til deterministiske performance-tests og menneskelig review.

Cursor slanker sit agent-harness — ikke sin dømmekraft

De halverer ikke bare prompts på gefühl: 66 % kortere systemprompt, værktøjer indlæst ved behov og bedre cachegrænser gav 7 % lavere tokenomkostninger uden målt kvalitetstab. Det er en opskrift på at måle hele opgaven, ikke blot tælle tokens i én request.

Cursor · Engineering

Inde i Cursors kontekstbudget

Tool-loading, caching, fil-læsning og subagents med konkrete A/B-målinger.

Opus 5.5 i praksis — og Claude mod race conditions

Efter gårsdagens launch er de brugbare tests mere interessante: 0xSero fik en Intel Arc-inference-stack med vision og concurrency til at køre på to timer efter lange forsøg med andre modeller. Boris Cherny beskriver samtidig, hvordan Claude modellerer særligt svære state machines, finder modeksempler og retter fejl — uden at hele SDK’et dermed er formelt verificeret.

0xSero@0xSero
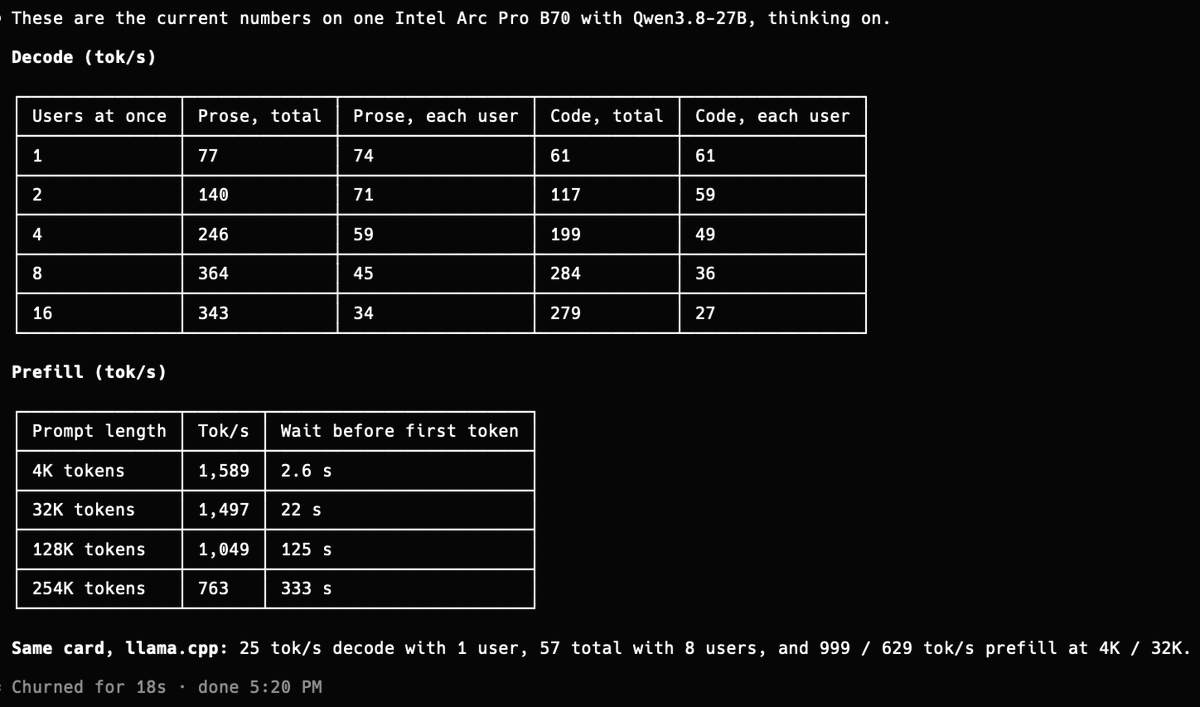
I made more progress in 1 day of Opus-5.5 on Intel Arc B70s than I did in 3 months with EVERY other model. In 2 hours it got exl3 working, and fixed decode and prefill and concurrency, MTP, vision. I had Sol on this for weeks of goals. https://t.co/K4EIKIel8W
Medie fra tweet
♥ 412 · ↻ 18 · 💬 29 · 🔖 83
x.com/0xSero/status/2102874568520298762
Boris Cherny@bcherny
More details for the formal methods people -- what's happening is Claude is doing something like: 1. Building a model of the program, targeting a tricky state machine or race-prone part of the code 2. Finding counter-examples in the model. These are suspected bugs 3. Reproducing the bugs 4. Fixing the bugs in the code It's not that the whole codebase is formally verified (yet!..), more that the hairiest parts of the code are modeled, checked for counter-examples, and fixed.
♥ 54 · ↻ 1 · 💬 17 · 🔖 35
x.com/bcherny/status/2102898067133595992

En lille model til store computeropgaver

Cua-S1-4B-0.2 er en åben 4B-beslutningsmodel med tekst- og multimodale adaptere. Den trænes på om hele GUI-opgaver faktisk bliver løst, ikke bare om næste klik ser plausibelt ud. Et konkret bud på, hvordan små specialister kan indgå i et større agent-loop.

Cua@trycua
1/ Today we're introducing Cua-S1-4B-0.2, the first multimodal decision model trained with RLOO on live computer-use tasks, using task-completion rewards. Text and multimodal adapters are available under Apache-2.0: https://t.co/0R5fWjfpGg https://t.co/rJnXsEdCKe
Medie fra tweet
♥ 1.212 · ↻ 104 · 💬 77 · 🔖 1.160
x.com/trycua/status/2102800643794591833
Hugging Face · Modelkort

Cua-S1-4B-0.2

LoRA-adaptere på Qwen3.5-4B med offentlig metode og kode.

Muse flytter ind i brillerne — og snart på nøgleringen

Meta vil lade Muse føre samtaler, se med og fortsætte opgaver i baggrunden via brillerne. Connect sluttede med Muse Charm, en lille selvstændig agent-skærm til nøgleringen; der findes kun få prototyper, men ambitionen er levering til december.

Mark Zuckerberg@finkd
Muse, your personal agent, now has voice and real-time video. You can have long conversations and Muse will work in the background and get things done for you as you're talking. We're also bringing Muse to glasses so you can talk hands-free throughout the day. https://t.co/0sfSXrYyvl
Medie fra tweet
♥ 1.831 · ↻ 101 · 💬 74 · 🔖 137
x.com/finkd/status/2102913007106093300
The Verge · Meta Connect, 23. september

Metas Muse Charm er en agent i lommeformat

Fingeraftryk til aktivering; forbindelsen og prisen er stadig ukendt.

Tal til arbejdet — lad laptoppen sove

ChatGPT Voice kan bruge mail, kalender og Slack via plugins og bygge dokumenter, sites og regneark i Work. Claude Code Cloud Sessions er samtidig ude af preview: opgaver kan køre videre efter laptoppen er lukket. To forskellige veje mod samme idé: agenten er en arbejdsflade, ikke kun en chatboks.

OpenAI@OpenAI
We heard you loud and clear. ChatGPT Voice can now: - Use plugins like your email, calendar, and Slack. - Be powered by GPT-6 Astra, Sol, and Luna. - Be used in ChatGPT Work on web and mobile, so you can create docs, decks, sites, and spreadsheets or tackle complex tasks in the browser, just by talking. Rolling out globally today in the latest version of the app.
Medie fra tweet
♥ 10.072 · ↻ 727 · 💬 580 · 🔖 2.283
x.com/OpenAI/status/2102808325742322002
ClaudeDevs@ClaudeDevs
Cloud sessions are officially available and out of research preview! They let you keep Claude Code working, even when your laptop is closed. Existing subscribers get a one-time credit to try them: $100 on Pro, $250 on Max. https://t.co/SvdB2ATkFw
Medie fra tweet
♥ 7.525 · ↻ 494 · 💬 256 · 🔖 4.562
x.com/ClaudeDevs/status/2102871550974427462

To små tests, der er mere værd end endnu en modelgraf

Simon Willison byggede et prøveværktøj til Gemini 3.8 Flash TTS: 1 minut og 18 sekunders dialog for 2,74 cent, med stemmer til to pelikaner. En uafhængig Jev-test ser lovende ud som dommer mellem to kodefixes, men evalsuiten er stadig under udvikling.

Simon Willison@simonw
The new Gemini 3.8 TTS models are super-cheap and can generate conversations between multiple voices (from 2,000+, or you can clone your own) - I built a little UI for it, then had Claude knock up a script where two pelicans debate moving to Pacifica Pier https://t.co/7PFM1ASAOl
♥ 397 · ↻ 14 · 💬 47 · 🔖 262
x.com/simonw/status/2102861892549279922
Simon Willison · Prøv selv

Gemini TTS-playground

Over 2.000 stemmer, flerstemmig tale og delbare kompositioner.

Morgan@morganlinton
Okay, my first complete benchmark of Jev with my new Decision v1 eval suite on @VulcanBench is done. I'll be honest, I'm still not totally happy with it, definitely needs some improvement. But there's something here, and it's starting to get more interesting to me, so I thought I would share it. As an independent benchmarker, I care less about perfection, and more about the process of learning and iterating, and generating as much signal and insights as I can along the way. I think the key insight I was able to get from this first run on Verdict v1 is that Jev is good at judging how well code is written. When I show it two fixes for the same bug, it picks the one an AI code reviewer prefers 90% of the time vs. 58% for guessing. And holy moly is it fast, it does this in about a third of a second per answer, versus about 22 seconds for Astra. Now live on the VulcanBench site with all the details here: https://t.co/kKjd5brHDW Model card below.
Medie fra tweet
♥ 17 · ↻ 0 · 💬 5 · 🔖 1
x.com/morganlinton/status/2102911971071009139

Hukommelse skal også forstå fravær

Dagens stille perle: en agent skal skelne mellem “slettet”, “flyttet” og “jeg mistede adgang”. Ellers kan gamle planer vende tilbage som fakta med en imponerende og komplet uberettiget selvtillid.

David Kofoed Wind@utdiscant
Most discussions about AI memory focus on how much you can add. How many documents can it index, how much context can it retrieve. But good memory also needs to track what disappeared. Companies change constantly. Documents get replaced. Files move around. People leave. Permissions get updated. If an AI system only piles up information, the old stuff doesn't go away just because it's no longer true. It just sits there and gets retrieved with the same confidence as everything else. When a file disappears, that doesn't always mean it was deleted. Maybe it moved. Maybe you lost access. Maybe the API gave you an incomplete list. You need the system to say: this source is current, this one was deleted, this one moved, and honestly we don't know what happened to this one so we're not going to guess. Even the fact that something was deleted or changed is important in itself (maybe there was a change of policy, or something got rescheduled). So you should not just store the data, but also the change log over the data.
♥ 1 · ↻ 0 · 💬 0 · 🔖 0
x.com/utdiscant/status/2102677852856721662

Nyhedsbonus

The Verge satte Muse til at rydde op i rigtige hverdagsting: en gartner fik en mail, et reservedelskøb kom i kurven, men telefonopkaldet måtte journalisten selv tage. Agenten var mest overbevisende, når den kunne bruge penge. Praktisk evaluering slår keynote-demoen.

The Verge · 23. september

En formiddag med Muse: god til indkøb, mindre god til telefoner

Fem konkrete opgaver, blandede resultater og meget lidt friktion ved checkout.

YouTube Music får samtalebaseret musikjagt og en personlig, oplæst podcastguide. “Hvad inspirerede den sang?” er et bedre udgangspunkt end endnu en algoritmisk playliste.

TechCrunch · 23. september

Ask Music og Your Podcast Lineup

Musiksøgning i naturligt sprog og korte podcastforslag; kommer snart til betalende brugere.