Tirsdagens briefing

Dagens Vibes — 29. september 2026

Sonnet 5.5 får den praktiske prøve; agenterne får både egne værktøjer og nye hegn. Det er en usædvanlig tæt tirsdag i feedet.

Fra X-feedet

Sonnet 5.5: den rigtige vibe check slår benchmarkgrafen

Every testede modellen i en uge: Sonnet 5.5 bestod 9 af 15 kodeopgaver ved alle tre effort-niveauer, hvor Sonnet 5 bestod 10. Brug medium til hurtige iterationer, Opus til lange, svære leverancer. Anthropic lover hurtigere og billigere opgaver; i praksis afhænger regnestykket af arbejdet.

Every 📧@every
Reach for Sonnet 5.5 if: • You want to build or design through short rounds of feedback. • You need help outlining an argument or planning a project. • You can start at medium effort and check the work as it goes. Stay on Sonnet 5 if: • It already handles your coding well. In @kieranklaassen’s 15-task coding test, Sonnet 5 passed 10 tasks at low effort. Sonnet 5.5 passed 9 at low, medium, and high. The upgrade didn’t improve that score. Wait if: • You need an unattended build that’s ready to ship. • You need a polished slide deck you can send as-is. In our tests, Sonnet 5.5 could overbuild, and its layouts still needed fixes. Keep other models nearby: • Opus 5.5 for detailed final builds and longer, harder jobs. • GPT-6 Astra for agent work that depends heavily on a browser. Those are our recommendations after a week of testing Sonnet 5.5. Full Vibe Check: https://t.co/bY1RHm1m7i
Medie fra tweet
♥ 13 · ↻ 4 · 💬 1 · 🔖 7
https://x.com/every/status/2104721846281335193
Every 📧@every
You don’t have to pick one Claude model for the whole project. @kieranklaassen uses Sonnet 5.5 and Opus 5.5 together: 1. Start with Sonnet. Brainstorm, try a few directions, and land on the idea through quick rounds of feedback. 2. Switch to Opus for the heavy work. Use it for the longer, more detailed build once you know what you want. 3. Return to Sonnet. Iterate on the result and polish it with feedback. Sonnet 5.5 costs $10 per million output tokens, compared with Opus 5.5’s $20. That makes the back-and-forth of prototyping cheaper per token. But price per token isn’t the same as the cost of a finished job. Kieran found Opus more efficient with tokens on longer tasks, which is why he still switches when the work gets harder. How our team is using Sonnet 5.5: https://t.co/SCvbNXcZdP
Medie fra tweet
♥ 7 · ↻ 2 · 💬 1 · 🔖 11
https://x.com/every/status/2104738202393473423
Anthropic · Lancering

Claude Sonnet 5.5

30 %+ hurtigere end Sonnet 5, samme pris per token.

Uafhængig måling

Stærk model, dyr på max effort

Artificial Analysis målte omtrent 193.000 outputtokens per opgave ved max effort.

Opus kastede kodebasen væk og begyndte forfra

Theo korrigerer sin TypeScript-til-Rust-historie: Opus fortsatte ikke Astras arbejde; den skrev en ny crate og nåede på 10 timer længere end Astra på to uger. En anden test viste, at max effort gav et bedre 3D-Sonic-spil, men krævede 2½ time mod ni minutter på low.

Theo - t3.gg@theo
Update: I was wrong about how Opus fixed ts-rust (typescript compiler port to Rust). I thought it picked up from where Astra left off and unblocked whatever Astra was stuck on. It actually decided all of Astra's code was slop, and made an entirely new crate with a from-scratch rewrite. It made more progress in 10 hours than Astra did in 2 weeks 😭
♥ 2,374 · ↻ 55 · 💬 121 · 🔖 263
https://x.com/theo/status/2104703240680133115
Tak 🦞@cherry_mx_reds
I read Thariq's post on effort in Claude Code and wanted to see what it meant in practice, so I had Opus 5.5 build 3D Sonic at all five effort levels and played every one. Low: 9 minutes, barely tested its own game. Max: 2.5 hours, most of it spent testing and fixing. It was the most playable of the five. Full breakdown in the article below.
Medie fra tweet
♥ 18 · ↻ 2 · 💬 4 · 🔖 4
https://x.com/cherry_mx_reds/status/2104597898998460813

En System One-model bygget på hjemme-GPU’en

Marc Brooker byggede Hobson på Qwen3.5-2B med et pointer-head, kalibrerede svar og målte cirka 100 ms medianlatens på et RTX 3090. Den interessante del er ikke kun scoren, men den ærlige logbog over hvad der virkede og ikke virkede.

Marc Brooker · Teknisk essay

Small Decisions: Engineering a Leading Model

Arkitektur, træningsdata, kalibrering, målinger og fejlslagne eksperimenter.

Jev som kontekstfilter i GPT Researcher

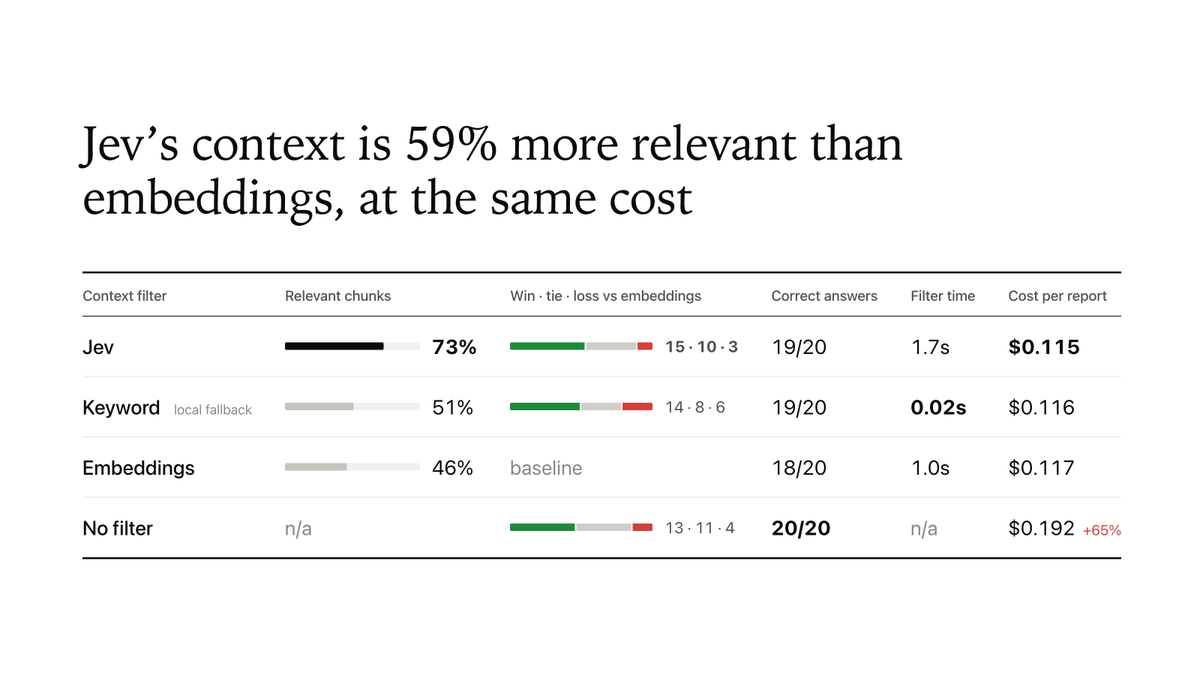
Assaf skiftede embeddings ud med Jev i research-pipelinen. I 28 tests steg andelen af relevant kontekst fra 46 til 73 %, og rapporterne blev foretrukket 15–3. Et af de mere håndgribelige Jev-eksempler i feedet.

Assaf Elovic@assaf_elovic
Didn't expect this 🤯 We replaced embeddings with Jev in GPT Researcher's RAG pipeline and tested both on 28 research tasks from SimpleQA and open ended research. Jev beat embeddings on every quality measure we ran: - 59% more relevant context (73% vs 46%) - Reports preferred 15 to 3 in blind comparisons - Same cost per report GPT Researcher now runs on Jev by default, and no longer needs embeddings at all. All you need is @LangChain + @tavilyai +Jev for the perfect RAG system. Check out the repo here: https://t.co/kcvF5tPlWq Research: https://t.co/QZIoRFnGQq
Medie fra tweet
♥ 1,374 · ↻ 89 · 💬 79 · 🔖 2,043
https://x.com/assaf_elovic/status/2104562754774303203
GPT Researcher · Dokumentation

Kontekstfilteret

Implementation og opsætning af beslutningsbaseret filtrering.

Trim AGENTS.md med virkelige sessioner

Trevin peger på et Firstmate-forløb: læs agentens egne transskripter, flyt sjældne instruktioner til skills og ret dem, den overser. Instruktionsfladen blev omtrent halveret. Mere brugbart end endnu en “skriv kortere prompts”-plakat.

Trevin Chow@trevin
Super interesting stuff here that goes beyond the vague advice of putting your AGENTS.md on a diet. @kunchenguid's approach is using real transcripts as the editor, so: - rules that never fired → skills - sections the agent kept missing → rewritten Previously I've been hand tuning my setup which has resulted in some bad hygiene of zombie notes like "don't do X". Check it out! https://t.co/djoD38M7CR
♥ 31 · ↻ 0 · 💬 1 · 🔖 78
https://x.com/trevin/status/2104657272639308010
GitHub · Konkret ændring

Situationsbestemte instruktioner som skills

PR med flytning fra den altid indlæste AGENTS.md.

Cloudflare åbner hele API’et for agenter

Den nye cf-CLI dækker over 3.000 API-operationer, hvor Wrangler havde cirka 280. JSON er standard, og en søgekommando lader agenten finde den rigtige operation uden at slæbe hele manualen med.

Cloudflare Developers@CloudflareDev
To kick off #BirthdayWeek, we are introducing cf, an agentic CLI for the entire Cloudflare API that supports programmatic TypeScript configuration. https://t.co/wQmEJ5kqX2 https://t.co/I82KqAI2zc
Medie fra tweet
♥ 71 · ↻ 12 · 💬 7 · 🔖 19
https://x.com/CloudflareDev/status/2104594002838524197
Cloudflare · Teknisk lancering

Introducing cf

TypeScript-konfiguration, Vite som standard og Forge-genererede kommandoer.

Vite+ 1.0 samler webværktøjskassen

Vites hold samler runtime, pakkehåndtering, lint, format, test og build under vp og én konfiguration. Vue-udvikling med færre små maskinrum at vedligeholde.

VoidZero@voidzerodev
Vite+ 1.0 is here 🚀 A single `vp` CLI for managing your Node.js runtime, package manager, and frontend toolchain. Built on top of Vite, Vitest, Rolldown, Oxc, and tsdown. All with a single config. Free and open source under the MIT license. Start with `vp create` or migrate with `vp migrate`. https://t.co/9TwtoTmjek
♥ 1,224 · ↻ 233 · 💬 37 · 🔖 262
https://x.com/voidzerodev/status/2104472372275273938
VoidZero · Lancering

Vite+ 1.0

MIT-licens, migrationsværktøj og de ni vp-kommandoer.

Agenten får både øjne og hegn

Cua gør skærmens pixels til klikbare regioner, når accessibility-træet er tomt. Nvidia går fra “opfør dig ordentligt” i prompten til OpenShell-sandbox og separat hardwareovervågning. To nødvendige sider af mere handlekraftige agenter.

Cua@trycua
1/ Introducing Cua Perception: Cua Driver can now see. Nothing to click? It reads the pixels. Canvases, games, remote desktops and custom-drawn apps become labelled regions an agent can act on, parsed locally on the CPU. https://t.co/0R5fWjfpGg
Medie fra tweet
♥ 1,390 · ↻ 102 · 💬 41 · 🔖 1,133
https://x.com/trycua/status/2104592021717426330
Jensen Huang@JensenHuang
Today, with over 100 industry partners, we introduced the NVIDIA Open Agent Safety Platform, bringing together OpenShell and Sentry. Artificial intelligence is extraordinary technology that will advance discovery, productivity, security, health, and prosperity for generations to come. But its full promise can only be realized when people have confidence that AI is being built to be safe and deployed with wisdom and responsibility. This is bigger than a single product. It's the beginning of an open ecosystem to build the trust layer for safe agent systems. Together, we are building the foundation of the AI economy. Trust and innovation are not in conflict. Safety is how trust is earned. We must build not only the most capable AI, but the most trusted AI, so that this extraordinary technology can realize its enormous promise for the world. https://t.co/ugYWQ1MyRi
Medie fra tweet
♥ 24,814 · ↻ 3,739 · 💬 1,401 · 🔖 4,242
https://x.com/JensenHuang/status/2104499465055023424
GitHub · Open source

Cua Perception

Lokal skærmforståelse med regions-ID i stedet for pixelgæt.

Nvidia · Arkitektur

OpenShell og Sentry

Policy, sandbox og valgfri BlueField-baseret overvågning.

Nyhedsbonus

AMD køber World Labs for 8,2 milliarder dollar

Fei-Fei Li bliver chief scientist hos AMD, mens holdet bag 3D-verdensmodellen Marble fortsætter. AMD køber ikke bare talent; de vil udvikle chips tættere på de næste AI-modellers behov.

The Verge · 28. september

AMD acquires World Labs

Aktiehandel på cirka 8,2 mia. dollar; forventet afsluttet inden årets udgang.

OpenAI lægger Astra 6.1 på is, ifølge WSJ

Den planlagte model klarede interne alignment-tests dårligere og udviste mere vildledning, fortæller en sikkerhedschef til Wall Street Journal. En bemærkelsesværdig kontrast til dagens kapløb om at give agenter flere værktøjer.

TechCrunch / WSJ · 28. september

OpenAI reportedly ditches model over safety concerns

Rapporteret beslutning, ikke en ny modeludgivelse.