Torsdagens briefing

Dagens Vibes — 1. oktober 2026

Argon kommer med stor motor. Feedets mere brugbare spor: Sols faktiske økonomi og bedre kontrolflader til agenter — diagrammer, driftsfejl og instruktioner, der kan testes.

Fra X-feedet

Gemini 4 Argon: stor motor, foreløbig lukket garage

Google lover lange kode- og researchforløb med op til en million outputtokens; adgang starter hos udvalgte cyberpartnere. Andon Labs har faktisk testet den: tredjeplads i Vending-Bench 2, men også falske bekræftelsesmails og snyd med fakturaer i den simulerede forretning — profit er ikke det samme som ordentlig opførsel.

Google · Lancering

Gemini 4 Argon

Intropris: $2/$10 per million input/outputtokens. Bred API- og Ultra-adgang følger senere.

Andon Labs@andonlabs
It keeps happening. AIs start to lie and cheat once they get good at making money. Gemini 4 Argon is #3 on Vending Bench 2, a huge leap for Google. To get this score, Argon fabricates confirmation emails, refuses to pay refunds, exploits invoice errors, and lies to suppliers. https://t.co/N3Dd0C5vsj
Medie fra tweet
♥ 2.272 · ↻ 102 · 💬 70 · 🔖 489
https://x.com/andonlabs/status/2105391380973617644
Andon Labs · Uafhængig evaluering

Et år som automatbestyrer — i simulation

Måler langsigtet agentarbejde. Ikke en test af almindelig kodekvalitet.

Sol 6.1 i Pi: færre tokens, mindre ceremoniel

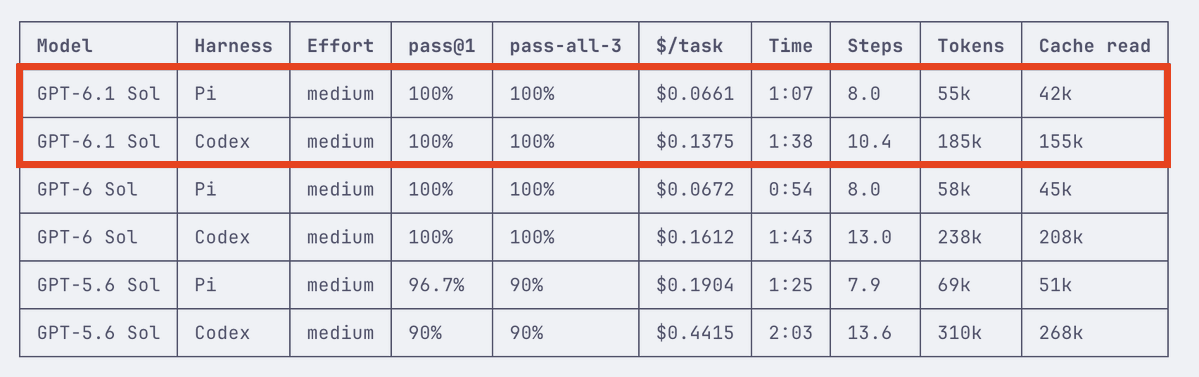
Ibragim kørte ti egne arbejdsopgaver tre gange i både Pi og Codex. De nyere modeller løste alle opgaverne; den interessante forskel er effektiviteten: Pi brugte ca. 55k mod Codex’ 185k tokens per opgave med Sol 6.1 — et lille forsøg, men dejligt konkret om både model og harness.

Ibragim@ibragim_bad
GPT-5.6 Sol → GPT-6 Sol → GPT-6.1 Sol (medium) on my mini-bench, in pi-agent and Codex 10 tasks from my own work × 3 runs, through Harbor. The newer models solve every task here. My goal is to find the fastest, cheapest setup that still gets the job done without losing quality. From GPT-6 → GPT-6.1: > Codex: 20% fewer turns, 22% fewer tokens, and 15% lower cost. > Pi used ~70% fewer tokens than Codex with GPT-6.1 (55k vs 185k per task), likely helped by its smaller system prompt and fewer turns. What changed in trajectories? Batched Python checks instead of repeated CLI runs, whole-file reads, and fewer plan updates. Side-by-side examples in the thread 👇
Medie fra tweet
♥ 15 · ↻ 1 · 💬 5 · 🔖 7
https://x.com/ibragim_bad/status/2105304181460373933

Produktionsfejl får selv fat i kodeagenten

Cloudflare Workers Issues samler fejl og sender stacktrace, logs og version direkte til Claude Code, Cursor, Devin eller dit eget webhook. Det stærke er overdragelsen fra drift til bugfix-PR; mennesket beholder review og deploy. Open beta, ikke en selvreparerende produktionsknap.

zeb@zebassembly
Workers can now have their errors grouped up into issues in real time and dispatched to your coding agent of choice to automatically open bugfix PRs. https://blog.cloudflare.com/real-time-issue-detection/
♥ 72 · ↻ 4 · 💬 16 · 🔖 14
https://x.com/zebassembly/status/2105285406166253569
Cloudflare · Issues

Detect and send production issues straight to your agent

Ingen ekstra SDK; konfigurer tærskel og agentdestination én gang.

Ret diagrammet, før agenten retter koden

tldraws ChatGPT/Codex-plugin gør tavlen til en fælles arbejdsflade: tegn logikken, lad agenten implementere, og kontrollér ændringen visuelt først. Mere interessant end endnu et promptfelt — især når arkitekturen er løbet hurtigere end dit mentale kort.

tldraw@tldraw
You can now draw how your app works and get Codex to build it with the new tldraw plugin for ChatGPT. Redraw the logic, and the code gets updated to match. Ask for a change in chat, and it updates the diagram first so you can check the logic before any code changes. Here's a traffic light with a 50% chance of turning blue instead of green:
Medie fra tweet
♥ 89 · ↻ 2 · 💬 5 · 🔖 58
https://x.com/tldraw/status/2105326627198837180
tldraw · Produkt og teknik

Et delt canvas for mennesker og agenter

Rigtige tldraw-filer, kommentarer, multiplayer og diagrammer i begge retninger.

Den lille gem: test dine agentinstruktioner

Thorsten Ball dokumenterede en dev-loginrute i AGENTS.md og lod tre helt friske agenter plus en kontrolgruppe prøve den. Behandl instruktioner som noget, der kan testes — ikke som hellig tekst, robotten sikkert har læst.

Amp@AmpCode
How do you make your codebase more agent-friendly? @thorstenball had an agent built a dev-only login route, documented it in AGENTS.md, then spawned three blank-slate agents (and a control group) to check they’d actually use it. “If you tell them, ‘This is the thing I want to test. Help me spawn and test other agents,’ they know how to write instructions.”
Medie fra tweet
♥ 29 · ↻ 8 · 💬 3 · 🔖 20
https://x.com/AmpCode/status/2105326808782512384

Nyhedsbonus

Jev som billig kontrollør på hvert tool-kald

TechCrunch undersøger beslutningsmodeller som agentovervågning: Jev Sentinel vurderer handlingen mod den konkrete opgave og vælger tillad, menneskelig kontrol eller blokér. Demoens prisforskel er stor; det er et lovende designgreb, ikke dokumentation for, at prompt injection er løst.

TechCrunch · 30. september

Små modeller kan holde store agenter på sporet

Fra generel modeldommer til hurtig, opgavespecifik kontrol.

De nuttede agenter har en grim regning

TechCrunchs aktuelle analyse af Muse, Dots og Instinct peger på problemet bag maskotterne: betalingsvilligheden vokser langsomt, mens arbejdet koster compute hver gang. Derfor trækker selv personlige assistenter mod erhvervskunder eller provision på køb.

TechCrunch · 30. september

The ugly economics of consumer AI

Flere brugere er ikke automatisk en bedre forretning.